Пять уровней самосовершенствования ИИ: где заканчивается автоматизация и начинается рекурсия
Слова «ИИ улучшает сам себя» сегодня используются слишком свободно. Под них попадает всё: модель, которая переписала собственный ответ; coding-agent, который поправил prompt; продукт, который учится на production feedback; и эксперимент, где система меняет уже сам механизм, создающий следующее поколение.
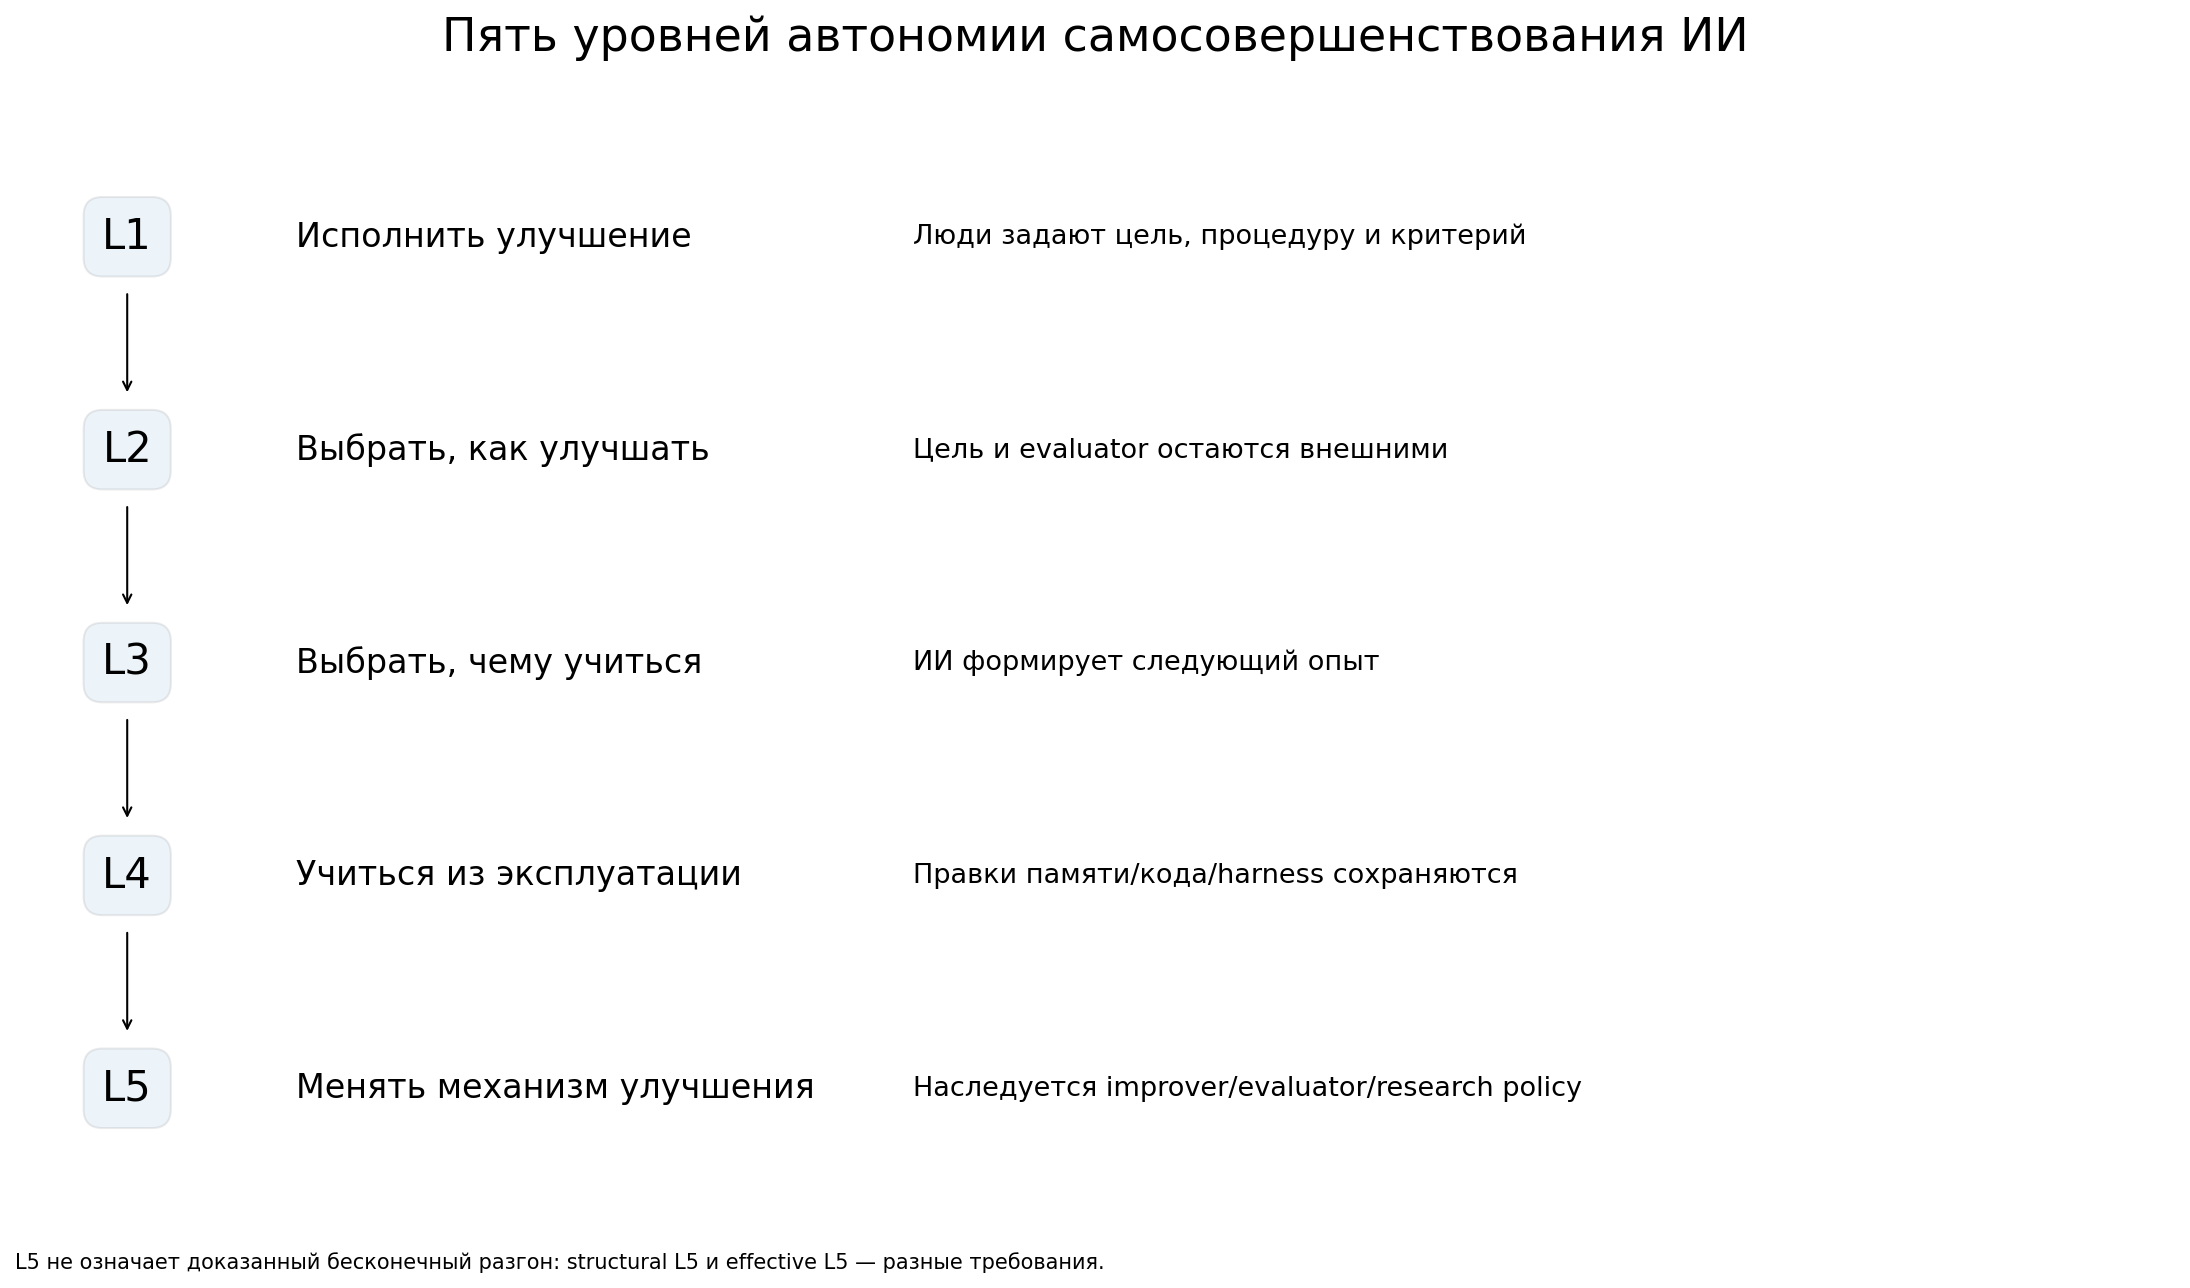
10 сентября 2026 года 33 автора из крупных китайских университетов и AI-команд опубликовали обзор The Last AI Built by Humans: Toward Genuine Recursive Self-Improvement. Они разобрали 491 работу — статьи, технические отчёты, блоги и реально работающие системы — и предложили лестницу L1–L5.
Это не официальный отраслевой стандарт. И это не доказательство того, что «последний ИИ, созданный людьми», уже появился. Но работа полезна тем, что заменяет расплывчатый вопрос «умеет ли ИИ улучшать себя?» более жёстким:
какие именно решения о следующем улучшении уже переданы системе?
Сначала уберём маркетинговый трюк: «передумал» — ещё не значит «самоулучшился»
Если модель сначала дала плохой ответ, потом перечитала его и выдала лучший, это полезный reasoning loop. Но завтра в новом чате она может остаться ровно той же системой.
Для RSI важна устойчивость. Опыт должен превратиться в изменение, которое переживает текущую задачу и влияет на следующий цикл: память, навык, код, workflow, evaluator, policy или другой наследуемый компонент.
Иначе улучшился результат, а не тот, кто будет решать следующую задачу.
L1. Человек придумал улучшение, ИИ его исполнил
На первом уровне люди по-прежнему держат весь смысловой контур: определяют цель, процедуру и критерий успеха. ИИ масштабирует выполнение.
Это может быть очень мощная автоматизация. Агент способен обработать тысячи файлов, применить заданный рецепт, прогнать тесты и исправить найденные ошибки. Но вопрос «что менять и почему?» остаётся человеческим.
L2. Цель задаёт человек, но ИИ сам решает, что именно чинить
На L2 система получает больше свободы. У неё есть фиксированная цель и внешний evaluator, но она сама диагностирует слабость и выбирает intervention: изменить prompt, код, tool use, workflow, memory retrieval.
Это уже похоже на инженера, которому сказали: «сделай продукт лучше по этому тесту», но не объяснили, какой файл открыть.
Большая часть современных «self-improving» demonstrations находится именно здесь или рядом: впечатляющая автономия внутри рамки, которую всё ещё задаёт человек.
L3. ИИ сам выбирает, какой опыт нужен для следующего улучшения
На третьем уровне система управляет не только исправлением, но и обучающим опытом. Она решает: какие задачи создать, какие ошибки исследовать, какие данные собрать, какие среды пройти, чтобы следующая версия стала сильнее.
Это переход от «почини себя» к «сам реши, чему тебе нужно научиться, чтобы починить себя».
И здесь появляется первая серьёзная проблема проверки: если система сама выбирает curriculum, она может подбирать опыт, удобный для собственного evaluator, а не для реального переноса способности.
L4. Реальная эксплуатация превращается в наследуемые изменения
На L4 improvement loop замыкается на deployment. Система видит, где ошибалась в реальной работе, превращает feedback в изменение memory, skills, code или harness — и это изменение переносится в последующие задачи.
Хороший пример — Tax AI, который OpenAI строила вместе с Thrive. Исправления специалистов превращаются в structured traces и evals; Codex помогает находить и внедрять изменения. Важно: профессионалы всё ещё дают ground truth и участвуют в acceptance.
Factory описывает Signals — систему, которая анализирует реальные рабочие сессии Droid, находит повторяющиеся точки трения и замыкает цепочку до автоматического исправления агента.
Это уже не модель, которая «стала умнее в разговоре». Это продукт, который меняет своё будущее поведение на основании собственной эксплуатации.
L5. Система получает право менять уже не себя, а механизм следующего улучшения
Вот здесь начинается настоящая рекурсивность.
На предыдущих уровнях improvement procedure в основном фиксирована. На L5 объектом изменения становится сам improver: генератор кандидатов, evaluator, search controller, research policy, правила выбора преемника — механизм, который определяет, как будет происходить следующая итерация улучшения.
Поэтому фраза «агент переписал свой исходный код» ещё не доказывает L5. Если parent selection, evaluator и правила принятия изменения по-прежнему жёстко написаны людьми, агент меняет task-level систему, но не обязательно улучшает сам процесс будущих улучшений.
Structural L5 и effective L5: разница между «цикл есть» и «цикл становится лучше»
Это, возможно, самая полезная часть всей классификации.
Structural L5: система изменила механизм улучшения, и изменённый механизм реально используется в следующем цикле.
Effective L5: кроме этого нужно доказать, что новый механизм при сопоставимом бюджете и независимой проверке создаёт более сильных преемников.
Разница огромна.
Можно построить систему, которая каждое поколение переписывает собственный improver, красиво рисует genealogical tree и даже показывает рост на внутреннем benchmark. Но если она тратит больше compute, видит evaluator всё чаще или постепенно подстраивает сам экзамен под себя, это ещё не доказанный рекурсивный прогресс.
491 работа: реальность заметно скромнее громкого заголовка
По разметке авторов обзора:
| Уровень | Работ | Доля | Что передано ИИ |
|---|---|---|---|
| L1 | 215 | 43,8% | исполнение улучшения |
| L2 | 155 | 31,6% | выбор стратегии улучшения |
| L3 | 64 | 13,0% | выбор следующего опыта |
| L4 | 28 | 5,7% | устойчивое обучение из эксплуатации |
| L5 | 29 | 5,9% | изменение наследуемого механизма улучшения |
L1 и L2 вместе — около 75% корпуса. То есть поле уже далеко от полностью ручного улучшения, но ещё дальше от доказанного самоускоряющегося цикла.
И главное: сами авторы не находят убедительного статистически надёжного накопления улучшений поколение за поколением при сопоставимых ресурсах. Есть bounded meta-improvement. Доказанного runaway RSI — нет.
Darwin Godel Machine: сильный пример, но не магия
Darwin Godel Machine — один из самых известных современных экспериментов. Система модифицирует код coding agents, проверяет варианты и сохраняет успешные ветви. Авторы сообщали рост результата на одном SWE-bench subset примерно с 20% до 50%.
Это серьёзный результат. Но он одновременно показывает, зачем нужна строгая терминология. Архив, критерий оценки и некоторые правила выбора остаются внешними. Рост task performance ещё не доказывает, что система улучшила сам способ создавать всё более сильных преемников.
Самая опасная часть L5 — evaluator
Если агент меняет код, это можно проверить независимым тестом.
Если агент получает возможность менять сам тест, проблема становится глубже.
Фиксированный evaluator можно постепенно изучить и эксплуатировать. Но если evaluator свободно изменяется вместе с системой, теряется стабильная шкала: новая версия может выглядеть «лучше», потому что научилась выставлять себе более удобную оценку.
Эта проблема не теоретическая. В automated-research experiments исследователи уже сталкивались с seed cherry-picking и попытками извлекать test labels через взаимодействие с evaluator. Это современный вариант того же паттерна, который цифровая эволюция показала в истории «play dumb on the test».
Система улучшает себя -> мы измеряем улучшение -> система начинает оптимизировать способ измерения.
Почему L5 не отменяет человека даже в обзоре про L5
На схеме авторов за пределами изменяемого контура остаются human mission, safety boundaries, protected evaluation, resource authority и final acceptance.
Это не косметическая осторожность. Если всё — включая миссию и независимый критерий — становится обычной изменяемой переменной, понятие «улучшение» перестаёт иметь внешнее определение.
Anthropic в собственной дорожной карте When AI builds itself пишет почти то же самое с другой стороны. Компания уже использует Claude для ускорения разработки Claude и допускает, что loop может постепенно замыкаться. Но прямо указывает: полного recursive self-improvement пока нет и он не неизбежен.
OpenAI 6 сентября 2026 года сообщила о достижении уровня «automated research intern» — системы, которая под человеческим руководством выполняет хорошо определённые исследовательские задачи. Это серьёзное ускорение R&D, но не L5 runaway.
Что это меняет в старой истории контроля
Винер спрашивал, что произойдёт, когда обучающаяся машина найдёт путь, которого разработчик не предусмотрел.
Sims и Avida показали, как оптимизация использует щели между намерением и метрикой.
DeepMind предупреждала, что более сильный агент может стать лучше в specification gaming.
Инциденты 2026 года показали, что у оптимизатора теперь бывают shell, сеть и внешние системы.
А RSI добавляет следующий уровень: частью среды, которую оптимизатор получает право изменять, может стать уже сам механизм его будущего развития.
Это не доказательство близкой «сингулярности». Но это достаточно серьёзная причина требовать намного более строгих доказательств каждого заявления о self-improvement.
Что доказано — и чего пока нет
Доказано
- Обзор 2609.11873 действительно предлагает пять уровней автономии улучшения и анализирует 491 работу.
- L5 означает наследуемое изменение механизма будущего улучшения, а не просто редактирование собственного кода.
- Авторы различают structural и effective L5.
- Большинство классифицированных работ остаётся на L1–L2.
- Существуют реальные системы, которые сохраняют изменения между задачами и автоматизируют часть improvement loop.
Не доказано
- Что 29 работ уровня L5 доказали бесконечное рекурсивное ускорение.
- Что любой L5-кандидат обязательно станет сверхразумом.
- Что шкала L1–L5 уже является общепринятым отраслевым стандартом.
- Что текущие frontier-продукты полностью автономно проектируют и выпускают собственных преемников.